13. Atenção: a ideia
Chegamos ao mecanismo que fez os transformers mudarem o mundo: a atenção (self-attention). É a peça mais rica, então vamos com calma.
O problema que ela resolve. Até agora, cada caractere sabe quem é (embedding
de caractere) e onde está (embedding de posição). Mas ele ainda está sozinho
— não conhece os vizinhos. E o sentido depende do contexto: depois de <obstacle>,
os próximos caracteres precisam formar uma reclamação. Para isso, cada caractere
precisa "olhar para trás" e perceber o que veio antes.
A ideia em uma frase: a atenção deixa cada caractere olhar para os outros e puxar informação dos que importam para ele — cada um decide sozinho onde focar.
A analogia da biblioteca (Query, Key, Value)
Imagine uma biblioteca. Cada token ganha três papéis:
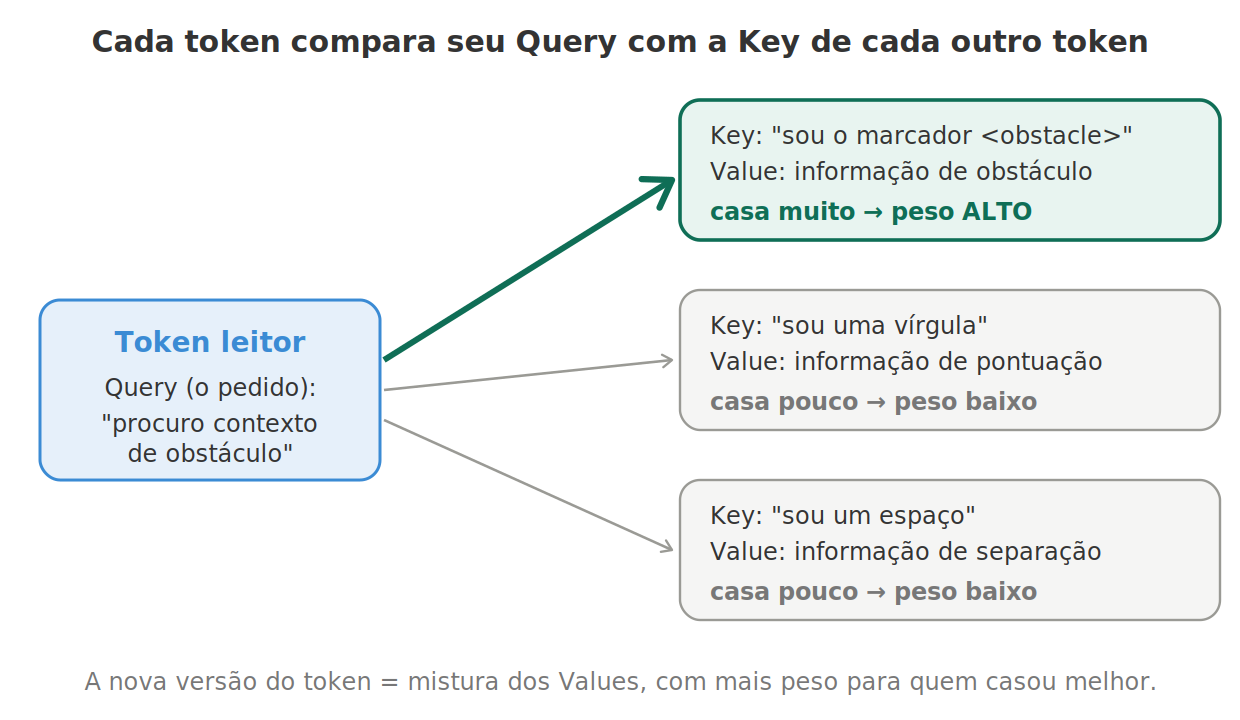
- Query (Q) — o pedido. O que este token procura. Como um bilhete: "quero algo sobre vulcões."
- Key (K) — a etiqueta. O que cada token anuncia sobre si. Como o rótulo na lombada de um livro: "este livro é sobre vulcões."
- Value (V) — o conteúdo. O que você leva se escolher aquele livro.
Cada token compara seu pedido (Q) com a etiqueta (K) de todos. Onde combina, a "nota" é alta. Aí o token monta sua nova versão pegando os conteúdos (V) dos outros, dando mais peso a quem combinou melhor. O detalhe elegante: cada token é ao mesmo tempo leitor e livro — tem um Query (para procurar) e também um Key e um Value (para ser encontrado).
De onde saem Q, K e V? Cada token já tem seu vetor (a soma dos embeddings). Multiplicamos esse vetor por três tabelas de pesos aprendíveis (chamadas Wq, Wk, Wv), e saem três vetores: o Q, o K e o V. São três "vistas diferentes" do mesmo token. As tabelas começam aleatórias e o treino as ajusta.