3. Como ela aprende
A LLM não nasce sabendo prever. Ela aprende num processo chamado treino, que funciona por tentativa e erro — parecido com um humano treinando um esporte. O treino tem sempre as mesmas quatro etapas, girando em círculo:
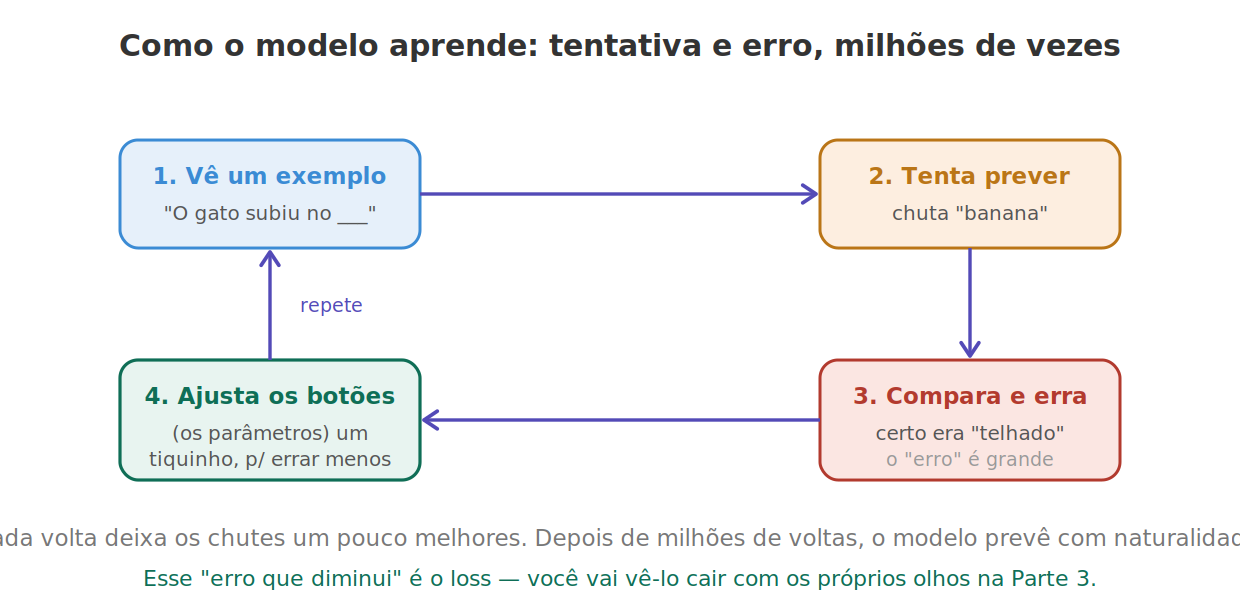
- Vê um exemplo de texto real (com a resposta certa escondida).
- Tenta prever o pedacinho que falta — no começo, chuta quase aleatoriamente.
- Compara o chute com a resposta certa e mede o quanto errou. Esse "tamanho do erro" tem um nome: loss.
- Ajusta seus botões internos (os parâmetros) um tiquinho, na direção que diminui o erro. E volta ao passo 1.
No começo ela erra quase tudo. Cada volta deixa os chutes um pouco melhores. Repetindo isso milhões de vezes com muitos textos, os chutes vão ficando tão bons que ela prevê com naturalidade.
No fim do treino, o "conhecimento" da LLM fica guardado nesses parâmetros ajustados. Cada parâmetro é como um botãozinho que o treino girou até a posição certa. Quanto mais botões, mais capaz (e mais pesado) o modelo.
Você vai fazer exatamente esse ciclo neste curso: mostrar exemplos ao modelo, ver o número do erro (o loss) diminuir a cada passo, e no fim ter um modelo que prevê texto no estilo sarcástico do seu robô.