12. Embeddings: a posição importa
O embedding de posição (a ordem importa)
Tem um detalhe: o embedding acima dá o mesmo vetor para o 'a', esteja ele no
começo ou no fim da frase. Mas ordem é tudo na linguagem:
"backup" e "pubcak" → mesmas letras, ordem diferente, sentido diferente
Para o modelo distinguir a ordem, criamos uma segunda tabela: o embedding de posição. Ela dá um vetor para cada posição (0, 1, 2...). Aí somamos os dois vetores — o do caractere e o da posição.
Exemplo concreto. O caractere 'c' na posição 0:
  vetor de 'c'    [ 0.2,  0.6, -0.1,  0.5]
+ vetor da pos 0  [ 0.1,  0.1,  0.0, -0.1]
------------------------------------------
= vetor final     [ 0.3,  0.7, -0.1,  0.4]
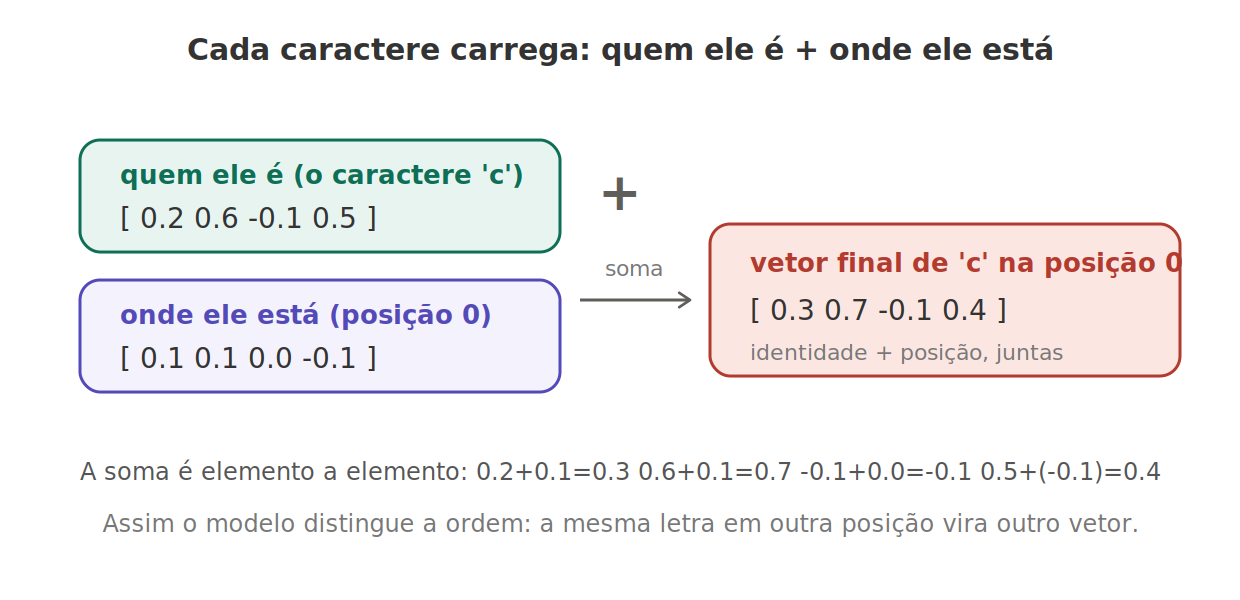
Agora cada caractere carrega duas informações num vetor só: quem ele é +
onde ele está. Se o 'c' estivesse em outra posição, o resultado seria diferente
— e é assim que o modelo passa a enxergar a ordem.
O código
O PyTorch tem uma peça pronta para tabelas de embedding: nn.Embedding(linhas, colunas).
Crie um arquivo embedding_demo.py:
import json
from pathlib import Path
import torch
import torch.nn as nn

# Carrega o vocabulário salvo pelo tokenizer
caracteres = json.loads((Path(__file__).parent / "vocab.json").read_text(encoding="utf-8"))
stoi = {c: i for i, c in enumerate(caracteres)}
def encode(s): return [stoi[c] for c in s]

tamanho_vocab = len(caracteres)   # 59
n_embd = 32                        # tamanho de cada vetor (nossa escolha)
block_size = 32                    # janela de contexto (posições)

# As DUAS tabelas
emb_caractere = nn.Embedding(tamanho_vocab, n_embd)   # (59, 32)
emb_posicao   = nn.Embedding(block_size, n_embd)      # (32, 32)

# Passa um texto pelos dois embeddings
texto = "cab"
entrada = torch.tensor(encode(texto))          # números do texto
posicoes = torch.arange(len(texto))            # [0, 1, 2]

vetores_caractere = emb_caractere(entrada)     # (3, 32)
vetores_posicao   = emb_posicao(posicoes)      # (3, 32)
entrada_do_modelo = vetores_caractere + vetores_posicao   # a soma

print("Formato da soma:", tuple(entrada_do_modelo.shape))  # (3, 32)
O que você deve ver: Formato da soma: (3, 32) — três caracteres, cada um com
um vetor de 32 números, já "temperado" com a posição.
A frase-resumo:
"Cada token vira um embedding de dimensão 32, buscando uma linha numa tabela de pesos aprendíveis. Somamos um embedding de posição, elemento a elemento, para o modelo ter noção de ordem."
Fim da Instalação 2. Agora os caracteres viraram vetores ricos que carregam identidade e posição. Na próxima instalação, o coração do transformer: a atenção — como cada caractere "olha" para os outros e decide no que prestar atenção.