2. Exportar os pesos
A ideia em uma frase: o script de exportação pega os ~215 mil números do modelo treinado, converte todos para um formato universal (float32), e salva num arquivo binário com uma "etiqueta" no começo.
O que é um arquivo binário? É a diferença entre um .txt (que você abre e lê) e
um arquivo que só o computador entende — uma sequência de bytes puros. O .bin é
desse segundo tipo: números empacotados de forma que o C leia rapidamente.
O que são os "pesos"? O modelo treinado é, no fundo, uma coleção de números — os ~215 mil valores que o treino ajustou. São eles que dão personalidade ao robô. Exportar é só empacotar esses números num formato que o C leia.
A estrutura do arquivo .bin
O arquivo tem duas partes, nesta ordem:
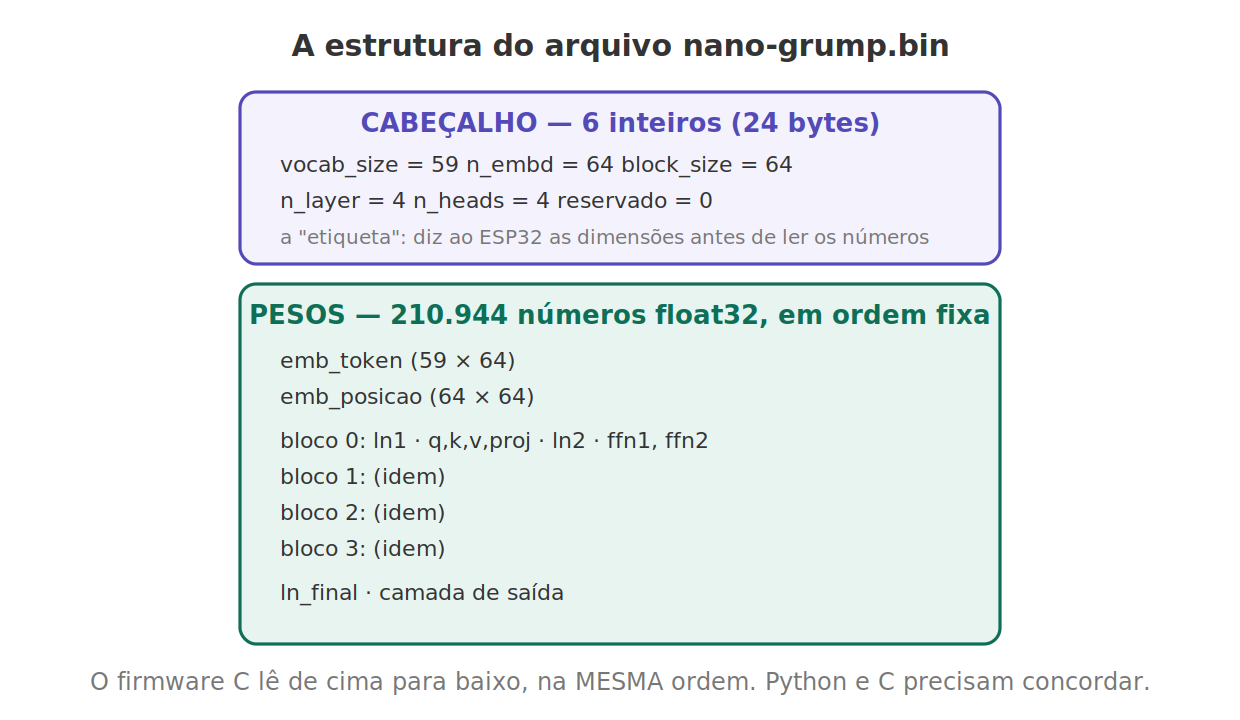
A ordem dos pesos tem que ser idêntica nos dois lados: o export.py escreve numa
ordem, e o firmware C lê exatamente na mesma. É como combinar previamente em que
gaveta fica cada coisa.
O código do export.py
"""
export.py — traduz o modelo_treinado.pt para nano-grump.bin
Uso:  uv run export.py
Saída: nano-grump.bin (pronto para gravar no ESP32-S3)
"""
import struct
from pathlib import Path
import torch
from model import MiniGPT, vocab_size, n_embd, block_size, n_layer, n_heads

pasta = Path(__file__).parent
modelo = MiniGPT()
modelo.load_state_dict(torch.load(pasta / "modelo_treinado.pt", map_location="cpu"))
modelo.eval()

# Converte um tensor PyTorch em bytes float32 (4 bytes por número)
def para_bytes(tensor):
    return tensor.detach().cpu().numpy().astype("f").tobytes()

with open(pasta / "nano-grump.bin", "wb") as f:      # "wb" = escrita binária
    # BLOCO 1: cabeçalho — 6 inteiros (a "etiqueta")
    f.write(struct.pack("6i", vocab_size, n_embd, block_size,
                        n_layer, n_heads, 0))

    # BLOCO 2: pesos, em ORDEM FIXA
    f.write(para_bytes(modelo.emb_token.weight))
    f.write(para_bytes(modelo.emb_posicao.weight))
    for bloco in modelo.blocos:
        f.write(para_bytes(bloco.ln1.weight));  f.write(para_bytes(bloco.ln1.bias))
        f.write(para_bytes(bloco.atencao.query.weight))
        f.write(para_bytes(bloco.atencao.chave.weight))
        f.write(para_bytes(bloco.atencao.value.weight))
        f.write(para_bytes(bloco.atencao.proj.weight))
        f.write(para_bytes(bloco.atencao.proj.bias))
        f.write(para_bytes(bloco.ln2.weight));  f.write(para_bytes(bloco.ln2.bias))
        f.write(para_bytes(bloco.ffn.rede[0].weight))
        f.write(para_bytes(bloco.ffn.rede[0].bias))
        f.write(para_bytes(bloco.ffn.rede[2].weight))
        f.write(para_bytes(bloco.ffn.rede[2].bias))
    f.write(para_bytes(modelo.ln_final.weight)); f.write(para_bytes(modelo.ln_final.bias))
    f.write(para_bytes(modelo.saida.weight))

print("nano-grump.bin gerado.")
Traduzindo os pontos novos:
struct.pack("6i", ...)empacota 6 inteiros em bytes — é o cabeçalho..astype("f")converte cada número para float32 (4 bytes), o formato que o C lê nativamente. É como trocar "xícaras" por "mililitros": mesmo valor, unidade universal."wb"abre o arquivo em modo de escrita binária.
Rode com uv run export.py. Você deve ver a criação do nano-grump.bin de ~840 KB
(≈215 mil números × 4 bytes).